世界模型Atlas发布:几张照片就能搭出机器人仿真场
2026 年,世界模型正从学术概念走向产业落地。World Labs 收购机器人仿真公司 SceniX,英伟达的 Cosmos 绑定算力主攻仿真,谷歌的 Genie 系列持续迭代;国内 Manifold AI 的 WorldScape 登顶多个榜单,摩尔线程的 MT Lambda 完成 Sim2Real 真机验证。路线分歧却越来越明显:这些号称能理解世界的模型,到底是在生成好看的画面,还是在搭建可用的空间?World Labs 九月发布的全球首个多模态世界模型 Atlas,恰好是一个可供剖析的样本。
交付的是画面,还是能直接跑起来的空间
Atlas 与 Sora 常被相提并论,但两者几乎只有「都在生成」这一点重合。Sora 做的是视频生成,关心像素之间的连贯性、运动的平滑度与视觉逼真感,最终交付一个视频文件。
Atlas 则是在给几张照片后,按照照片画面重建出相同的 3D 场景:照片被锚定在三维坐标上,模型据此还原几何结构。它关心空间坐标准不准、程序能否直接读取,交付的是点云、3D 高斯泼溅这类可供计算机直接解析的几何数据,程序可以直接使用,机器人仿真器也能直接导入运行。
空间上下文,让每张照片自带坐标
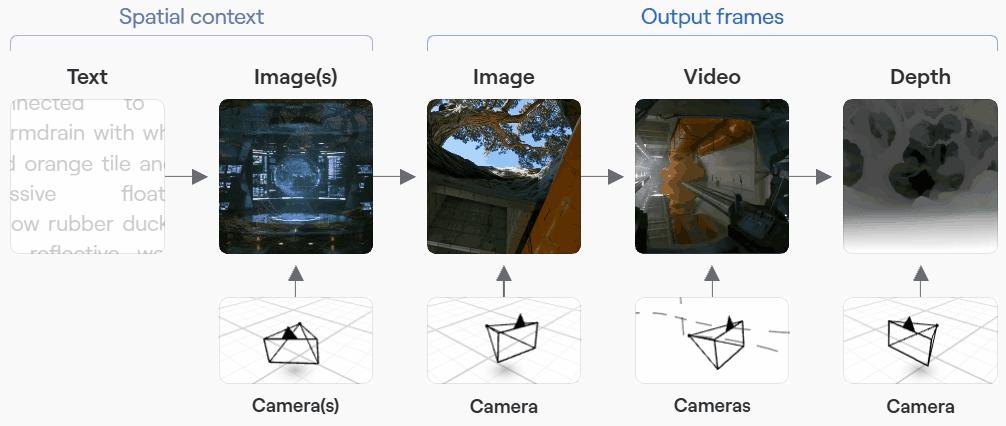
传统视觉输入处理的是二维像素,没有深度和遮挡关系;Atlas 让每帧图像自带三维坐标,输入从「拍到了什么」变成「从哪拍的、和周围什么关系」。这与大语言模型用文字上下文预测下一个词一脉相承,只是把文字换成了带坐标的照片:房间里朝东、朝北、朝西的三张照片,传统模型看到的是三张独立平面图,Atlas 能拼成完整的三维房间地图。
几张手机照片,搭出可用的训练场
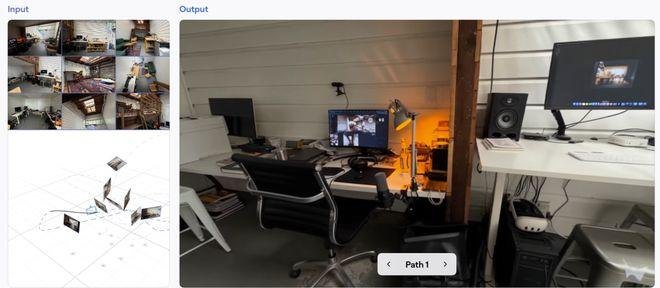
最少 2 张、最多 25 张普通照片,就能输出可被仿真器直接导入的完整 3D 场景。官方演示的逐步构建过程很直观:只给一张办公桌局部特写时,桌椅墙面全靠模型「脑补」;加入第三张侧面双屏工作台的照片后,整个场景才完整对齐。
官方透露,通常两到三张图就能完成可用重建,斯坦福大学主方庭更是仅靠几张地面拍摄的手机照片,就生成了从高空俯瞰校园的连续飞行画面。过去搭建机器人训练场地要扛着设备转几十圈、拍数百张照片、再花几天建模,如今一部手机、一段视频就能完成。
相机可控与时空模拟:让世界动起来
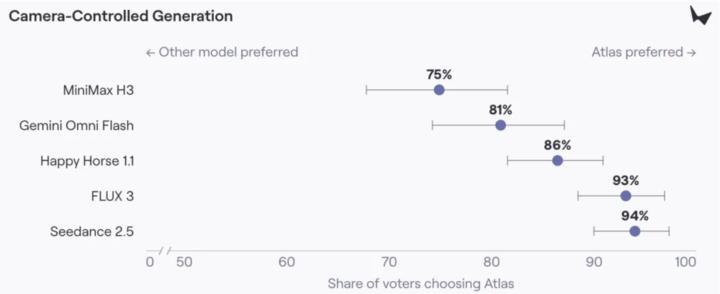
输入 1 到 6 张参考图并设计一条相机运动轨迹,Atlas 可生成最高 1440p、最长 1 分钟的视频。第三方盲测中,它以相机位姿为原生输入,对 MiniMax H3 的胜率是 75%,对阿里 HappyHorse 1.1 是 86%,对字节 Seedance 2.5 是 94%。
时空模拟则让三五台普通手机同步录制就能实现时间冻结与多视角回看。用于仿真时,World Labs 用手机拍下两个大型环境、各取 24 帧重建 3D 场景,再模拟机器人沿不同路径行走,实时生成传感器应看到的 RGB 画面和深度信息。
几何之外,物理才是真正的硬仗
Atlas 解决的是几何问题,还算不出物理问题——东西怎么动、多重、摩擦多大、会不会变形。在 Real-to-Sim 工作流中,它生成的数据只有 RGB 图像和深度图,不含碰撞检测、刚体动力学参数或接触力结果,物理演算要对接 MuJoCo、PhysX 等外部引擎;损失函数基于图像帧预测误差,优化的是画面保真度而非物理准确性。
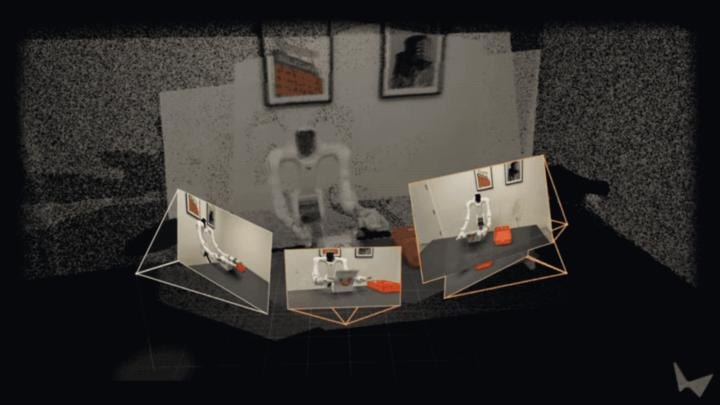
2026 年 7 月,World Labs 收购了用物理信息增强数字资产的机器人仿真公司 SceniX,同月公布 Real-to-Sim-to-Real 工作流:把真实操作视频转化为带物理属性的仿真环境,在其中训练策略后再部署回真实机器人。演示中,RB-Y1 机械臂完成线缆操作,YAM 机械臂完成可变形物体操控,所有策略零真实数据、直接迁移到多种真实机器人平台,自主运行一小时无人工干预。
几何可以靠算法从照片反推,但线缆的阻尼、布料的编织方式、关节的摩擦特性,都只能靠真实物理交互来标定。当空间结构与物理规则真正统一起来,世界模型才算走完从感知到理解的全链路。